Stavíme Rentrio, SaaS pro správu pronájmu. Dvě čísla v něm nejsou naše: zákonný úrok z prodlení a míra inflace. Obě vyhlašuje stát, obě jsou veřejná a obě jdou stáhnout z API.
Nejsou to čísla na ozdobu. Aplikace z nich generuje dokumenty, které odcházejí druhé straně. Z míry inflace se počítá oznámení o zvýšení nájemného podle inflační doložky; noční úloha projde smlouvy, u kterých nastal termín valorizace, spočítá novou částku a připraví dodatek. Z úroku z prodlení se počítá částka v upomínce a v předžalobní výzvě.
Odesílá to vždycky člověk a nikdy ne aplikace sama, ale číslo v tom dokumentu už předvyplněné je. V tom je celý důvod, proč se zbytek textu tolik zabývá hodnotami, které vypadají věrohodně.
Původně jsme obě měli natvrdo v kódu. „Zadrátovaná“ čísla mají jednu nedoceněnou přednost: selžou hlučně a v předvídatelný den. Od ledna by kalkulačka každému, kdo počítá úrok z nového dluhu, hlásila „chybí sazba“. Když jsme přešli na API, selhávání ztichlo a začalo být mnohem zajímavější.
Následuje šest konkrétních případů. Na většinu jsme přišli při stavbě, jeden nás kousl v produkci a jednomu jsme se vyhnuli návrhem, protože bylo dopředu vidět, kudy přijde. Spojuje je jediná vlastnost, ke které se na konci vrátím: ani jeden by nevyhodil výjimku.
1. Endpoint odpovídající na jinou otázku
Nařízení vlády č. 351/2013 Sb. říká v § 2, že výše úroku z prodlení odpovídá ročně výši repo sazby „stanovené Českou národní bankou pro první den kalendářního pololetí, v němž došlo k prodlení“, zvýšené o osm procentních bodů. Sazba se určí jednou a po celou dobu prodlení se nemění, i kdyby ČNB mezitím sazby změnila desetkrát.
ČNB provozuje veřejné API bez klíče a bez registrace. Sazby na peněžním trhu jsou na endpointu operací na volném trhu: GET https://api.cnb.cz/cnbapi/omo/daily?date=2026–07–01&lang=CZ
Vrátí pole operací, každá s typem, směrem dopadu na likviditu a mezní sazbou. Vypadá to přímočaře: najdi operaci typu Repo, vezmi marginalRateInPercent, přičti osm.
Jenže tenhle endpoint nehlásí měnověpolitickou sazbu. Hlásí operace, které se ten den doopravdy konaly.
Všimněte si, jak přesně to míjí text předpisu. Ten mluví o sazbě stanovené pro daný den, nikoli o sazbě, za kterou se ten den něco obchodovalo. Zní to jako slovíčkaření, ale právě v téhle mezeře leží obě chyby, které následují.
2. Den, kdy se neobchodovalo
Jsou dny, kdy ČNB žádný repo tendr nevypsala a běžela jen depozitní facilita. Sazba samozřejmě platila dál, jen se ten den neobchodovalo. Takový den padl mimo jiné na 1. 1. 2014, 1. 7. 2014, 1. 1. 2020 a 1. 7. 2021.
Dotaz na jediný konkrétní den tak u čtyř pololetí nevrátil nic. Aplikace v tu chvíli po uživateli chtěla, ať si sazbu dohledá sám, přestože veřejně dostupná byla.
Řešení plyne z povahy té sazby: platí až do další změny, takže k prvnímu dni pololetí ji určuje poslední repo tendr před ním. Když se v daný den nic nenajde, couváme po dnech dozadu. V praxi stačí jeden až dva dny.
Mez jsme nastavili na čtrnáct dní a delší schválně ne. Kdyby ČNB tendry na měsíce zastavila, couvání by doneslo sazbu z doby, kdy mohla být jiná. Čtrnáct dní pokryje i vánoční svátky a zůstane v mezích, kdy se sazba nemohla nepozorovaně změnit, protože každá změna se vyhlašuje po zasedání bankovní rady.
K tomu jedna pojistka: má-li nalezená operace datum obchodu pozdější než první den pololetí, zahodíme ji. Jinak by couvání mohlo dovléct sazbu, která tehdy ještě neplatila.
Výsledkem je řada od prvního pololetí 2014, tedy od účinnosti nařízení, po dnešek: https://rentrio.cz/data/urok-z-prodleni. Hlouběji schválně nesahá; pro starší prodlení platil jiný předpis s jiným vzorcem a tabulka by pro ty roky tvrdila číslo, které nikdy neplatilo.
3. Tichá chyba za dvacet setin procenta
Tahle je horší, protože nespadne. Vrátí číslo, které vypadá věrohodně.
Operace typu „Repo“ nejsou jedna věc. Měnověpolitická repo operace likviditu stahuje, tedy banky u ČNB peníze ukládají, a mezní sazba takové operace je právě dvoutýdenní repo sazba. Vedle toho existuje repo operace se směrem „Dodání“, což je jiný nástroj s jinou sazbou.
Konkrétní případ: 15. 6. 2021 hlásí ČNB repo „Dodání“ se sazbou 0,45 % a nulou nabídek, tedy tendr, na který nikdo nepřišel. Repo sazba tehdy byla 0,25 %.
Kdo filtruje jen podle typu operace, dostane 0,45 % a spočítá úrok 8,45 % místo 8,25 %. Takové číslo skončí v předžalobní výzvě a nikdo si ho nevšimne. Nikde nevyskočí výjimka, nic se nerozbije, jen je výsledek špatně.
Zrádnost umocňuje, že správná hodnota se v tom období rychle měnila. Bankovní rada sazbu koncem června 2021 zvedla na 0,50 %, takže pro druhé pololetí 2021 platí úrok 8,50 %. Tři velmi podobná čísla během několika týdnů, z nichž dvě jsou pro daný případ špatně.
Filtr proto musí zahrnout i směr dopadu na likviditu:
operations.find(o =>
o.operationType === ‚Repo‘ &&
o.liquidityImpact === ‚Stažení‘)
Drobnost, která se lehce přehlédne: ptáme se s lang=CZ, takže i hodnoty se vracejí česky. Kdo se ptá anglicky, filtruje na jiný literál. Změna jazyka v dotazu tichou chybu vrátí zpátky.
4. Adresa měnící se při každé publikaci
Roční míra inflace je jiný příběh. Inflační doložka v nájemní smlouvě se odkazuje na „míru inflace vyjádřenou přírůstkem průměrného ročního indexu spotřebitelských cen“, což je konkrétní veličina, kterou ČSÚ vyhlašuje jednou ročně v lednu. Není to meziroční index z libovolného měsíce a není to HICP z Eurostatu; obojí dává jiné číslo.
Data jsou v otevřené sadě 010022 jako CSV. První past je hned u adresy: nese datum vydání a náhodný identifikátor, dnes například 010022–25data011326.csv. Při každé publikaci se změní.
„Zadrátovaná“ adresa by přestala platit tiše. Stará adresa dál funguje a soubor se stáhne, jen v něm nepřibývají data. Proto se pokaždé nejdřív načte katalogový záznam v DCAT a adresa se vytáhne z něj; katalogová adresa je trvalý identifikátor sady a nemění se.
Kdo katalog DCAT-AP-CZ čte poprvé, čeká ho drobný kulturní šok: názvy polí jsou česky, a to včetně diakritiky. Hledá se soubor_ke_stažení, přístupové_url, typ_média, formát a časové_pokrytí. Není to nedbalost, standard to tak má. Jen si na to připravte klávesnici a nezapomeňte, že háček v klíči objektu je pořád jen znak jako každý jiný.
A pak jedna věc, kterou jsme málem udělali špatně: distribuci je potřeba vybírat podle typu, ne podle pořadí. Naše sada má dnes jedinou, takže by distribuce[0] vycházelo. U velké části katalogu ČSÚ je ale na prvním místě něco jiného než CSV, a jakmile sem ČSÚ přidá třeba XML variantu, výběr podle pořadí tiše stáhne špatný soubor. Nic nespadne, jen se bude parsovat něco jiného.
K tomu kontrolujeme doménu. Z rozbité nebo podvržené odpovědi katalogu se nesmí dát stáhnout cokoli odkudkoli.
5. Tři čárky v názvu skupiny
CSV od ČSÚ má uvozovky kolem každého pole a v textových popisech se vyskytují čárky. Skupina 04 se jmenuje „Bydlení, voda, energie, paliva“, tedy tři čárky v jedné buňce.
Naivní split(‚,‘) tady posune všechny následující sloupce. Poprvé se to projevilo tak, že v poli s kódem časového srovnání seděla data. Skript nespadl, jen četl nesmysl. Skončilo to vlastním parserem podle RFC 4180, který umí i zdvojené uvozovky uvnitř pole.
K tomu jsme přidali rozsahovou pojistku. Index spotřebitelských cen se pohybuje kolem stovky, takže hodnota mimo interval 50 až 300 neznamená rekordní inflaci, ale že čteme jiný sloupec. Takový řádek zahazujeme.
6. Čtyři řady, z nichž tři dávají špatné číslo
Tohle je podle mě nejzrádnější místo celé integrace a nejde o technický problém, ale o pochopení dat.
Sada obsahuje v jednom souboru čtyři různá časová srovnání, rozlišená sloupcem casz_kod:
K | srovnání se stejnými 12 měsíci předchozího roku
C | stejné období předchozího roku (meziroční index)
B | proti předchozímu období
Z | proti průměru bazického roku
Míru inflace, na kterou odkazují inflační doložky, dává jedině řada K, a to řádek za prosinec. Ostatní tři vracejí čísla, která vypadají úplně stejně věrohodně a jsou o procento nebo dvě jinde. V testech proto máme vzorek, kde jsou všechny čtyři řady zároveň, aby bylo poznat, že se sáhlo po té správné.
Ověřili jsme to zpětně proti veřejně známým hodnotám: rok 2022 vychází 15,1 % a rok 2023 10,7 %, což jsou čísla, která ČSÚ vyhlásil.
Do toho spadá ještě jedna změna, na kterou je potřeba se připravit. Do roku 2025 se používá klasifikace ECOICOP, kde úhrn nemá kód a pole ucel_kod je prázdné. Od roku 2026 přechází ČSÚ na COICOP 2018, kde úhrn dostal explicitní kód „0“. Kód, který hledá jen prázdný řetězec, by na nových datech nenašel nic, a co je horší, mohl by sáhnout po jiné skupině. Přijímáme proto obojí.
Poznámka pro ty, kdo tuhle sadu budou zpracovávat: CSV mělo v srpnu 2026 skoro tři megabajty a Next při buildu hlásí „items over 2MB can not be cached“. Není to chyba, jen se soubor nevejde do datové cache a stáhne se pokaždé, když se stránka přegeneruje. U ISR s denní platností je to jednou za den. Po síti to navíc díky kompresi gzip není 3 MB, ale zhruba 430 kB.
7. Zrušení, které se z odpovědi nedozvíte
Tenhle případ je z celého seznamu nejdražší. Osm měsíců jsme o něm nevěděli.
Aktuální inflaci jsme tahali z Eurostatu, sada prc_hicp_manr. Eurostat ji zrušil a nahradil sadou prc_hicp_minr. Souvisí to s širší změnou: k 4. únoru 2026 prošla harmonizovaná inflace v eurozóně metodickou revizí a ECB téhož dne ukončila i svou sadu ICP.
Původní sada má dnes datové pokrytí do prosince 2025 a poslední aktualizaci ze 6. února 2026. Endpoint ale dál odpovídá HTTP 200 a vrací data, jen jich nepřibývá.
Podstatné je, že Eurostat to oznámil. Stojí to na stránce sady, hned pod popisem, velkým písmem. Jen to nestojí v odpovědi API, protože oznámení pro člověka a odpověď pro stroj jsou ve většině institucí dva nezávislé kanály.
V srpnu 2026 tedy banner valorizace v aplikaci předvyplňoval hodnotu z prosince 2025 a nic na to neupozorňovalo, protože po technické stránce bylo všechno v pořádku. Žádná chyba, žádný timeout, žádný nevalidní JSON. To číslo přitom jde rovnou do dodatku ke smlouvě.
Poučení se dá shrnout do jedné věty: u zdroje, který mlčky zestárne, nestačí hlídat chybu, musí se hlídat datum.
Teď u každé odpovědi počítáme stáří posledního období a nad tři měsíce ho označíme za zastaralé. Sada se vydává měsíčně s několikatýdenním zpožděním, takže dva měsíce jsou normální, tři už ne. Zastaralost není chyba, kterou bychom skryli; stránka ji musí říct nahlas.
Náhradou je živé API ČSÚ, sada WCEN01, formát JSON-stat 2.0. Zajímavé je, že jsme nakonec ponechali oba zdroje. Otevřená data mají členění po skupinách, tedy i „Bydlení, voda, energie, paliva“, ale vydávají se jednou ročně a v srpnu 2026 pořád končila prosincem 2025. Živé API nabízí naopak jen úhrn, zato je čerstvé a jeho odpověď má 51 kB.
Stránka používá obojí, každé na to, v čem je lepší, a u každé hodnoty říká, odkud pochází: https://rentrio.cz/data/inflace.
8. JSON-stat a ukazatele, které jsou prázdné vždycky
JSON-stat drží hodnoty v jednorozměrném poli a index se počítá z pořadí dimenzí v id a jejich velikostí v size. Chyba ve výpočtu indexu nevrátí chybu, ale hodnotu jiného ukazatele nebo jiného měsíce. Vytáhli jsme si proto ten výpočet do samostatné funkce a otestovali ho zvlášť, včetně souřadnic mimo rozsah.
A jedna past přímo v datech: sada nese i ukazatele s hotovými procenty, konkrétně 6134J06 a 6134J09. Ty jsou prázdné ve všech obdobích. Kdo se na ně spolehne, nedostane chybu, ale prázdnou hodnotu. Míru inflace proto počítáme z indexu, tedy hodnota mínus sto.
Mimochodem, i takhle triviální aritmetika umí překvapit. Sečtení repo sazby s přirážkou probíhá v pohyblivé řádové čárce, takže 3,75 + 8 vyjde v JavaScriptu jako 11.750000000000002. Do referenční tabulky by se to propsalo jako nesmyslně přesné číslo. Repo sazba má nejvýš dvě desetinná místa, proto zaokrouhlujeme na dvě; nic se tím neztrácí.
Co mají ty chyby společné
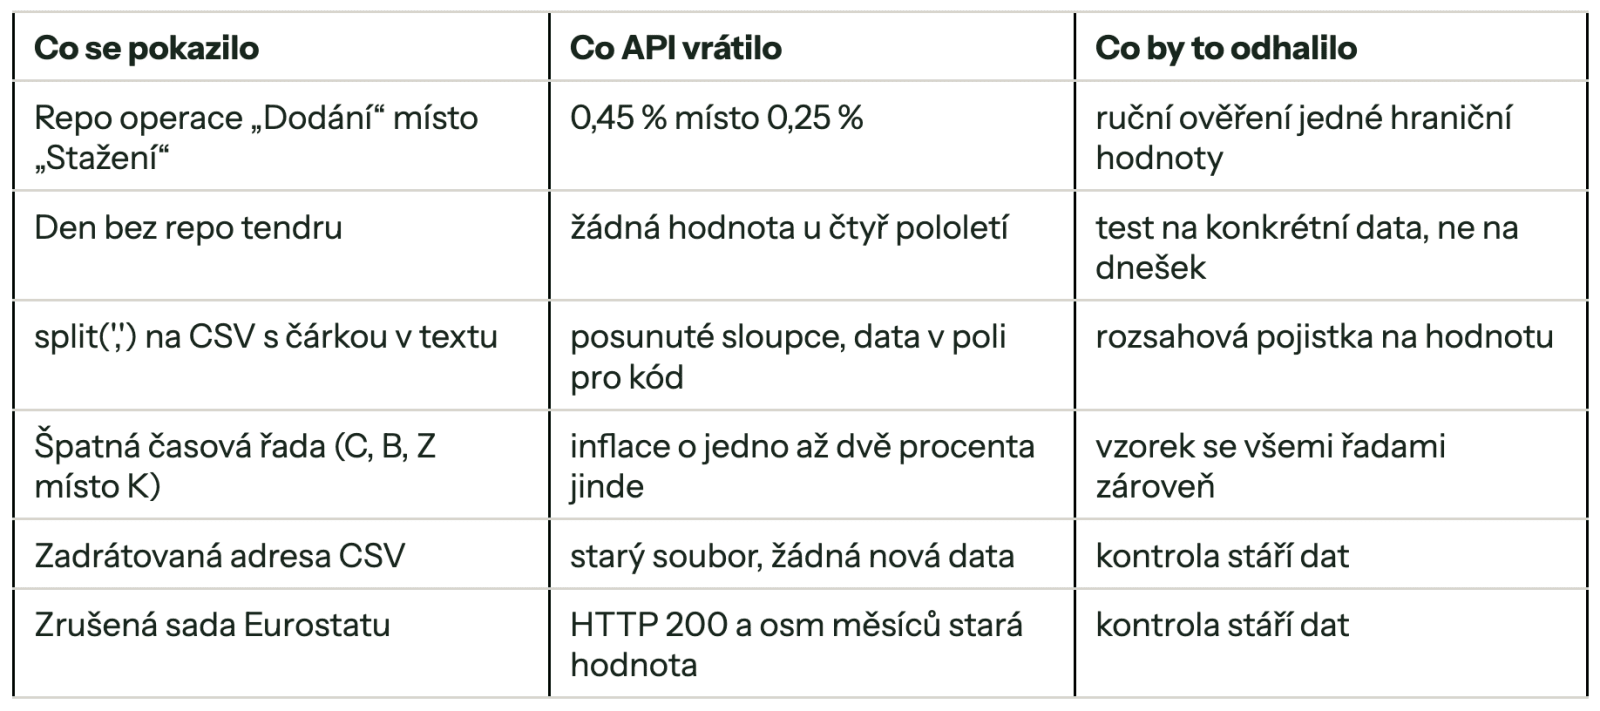
Vraťme se k tomu, čím jsem začal. Šest případů, ani jeden pád:
Práce s API ČNB
Ve všech šesti případech by ošetření chyb podle učebnice, tedy try/catch a kontrola stavového kódu, nezachytilo vůbec nic. Bylo by nutné ptát se na něco jiného: dává tohle číslo smysl, je z té řady, kterou chci, a je dost čerstvé?
Z toho nám vyšla tři pravidla, která teď držíme u každé integrace.
Zaprvé, rozsahové pojistky. U repo sazby přijímáme jen hodnotu mezi nulou a padesáti procenty, u indexu spotřebitelských cen mezi padesáti a třemi sty body. Ty meze nemají předvídat budoucí vývoj sazeb; mají zabránit tomu, aby se do výpočtu dostalo číslo z jiného pole nebo z poškozené odpovědi.
Zadruhé, kontrola stáří u všeho, co se v čase mění. Eurostat nás naučil, že úspěšná odpověď a čerstvá data jsou dvě různé věci.
Zatřetí, a to je nejdůležitější: při jakémkoli selhání vracíme prázdnou hodnotu a necháme uživatele doplnit ji ručně. Nikdy nedosazujeme poslední známou hodnotu ani sousední pololetí.
Ten poslední bod je jediné skutečně obtížné rozhodnutí celé práce, protože jde proti instinktu vývojáře i proti tomu, co chce produkt. Prázdné pole vypadá jako nedodělek. Jenže chybějící údaj uživatel vidí a doplní, kdežto špatný údaj nevidí nikdo a odejde s ním předžalobní výzva nebo dodatek ke smlouvě. U čísla, ze kterého se počítá zákonný nárok, je odhad horší než mezera.
Ze stejného důvodu nevypisujeme v tabulce ani budoucí pololetí. Sazba pro ně neexistuje a prázdný řádek dopředu jen svádí k tomu si tam něco doplnit.
Jak se tohle testuje
Zdroj, který nemáte pod kontrolou, se testovat nedá. Testovat jde ale všechno kolem něj, a to je většina kódu.
Rozdělili jsme každou integraci na dvě části. Čistou, tedy parsování, výběr řady, výpočet a kalendář pololetí, kde se nesahá na síť a jde otestovat všechno. A tenkou síťovou vrstvu, která jen stáhne odpověď a předá ji té čisté.

Testy pak nepíšeme na bezproblémový průběh, ale právě na tyto pasti. V testovacím vzorku CSV jsou schválně všechny čtyři časové řady zároveň, aby bylo poznat, že se sáhlo po té správné. Je tam řádek se správnou řadou, ale jiným měsícem. Je tam hodnota mimo rozsah indexu. Je tam odpověď se změněnou strukturou, u které se ověřuje, že nevrátí nic, a ne náhodná čísla. A je tam zastavený zdroj s osm měsíců starými daty, přesně situace Eurostatu.
U ČNB máme navíc testy, které kontrolují samotný zdrojový kód: že v serverové části není žádná záložní konstanta, tedy že se to, co se nenačte, nikde nevymyslí. Vypadá to zvláštně, ale právě takovou konstantu tam za rok někdo v dobré víře přidá, aby stránka „nebyla prázdná“.
Proč jsme výsledek zveřejnili
Obě řady jsou veřejně na https://rentrio.cz/data bez registrace a bez reklamy. U každé hodnoty je uveden zdroj i předpis, ze kterého plyne, a data jsou k dispozici i strojově čitelně.
Důvod je prostý. Tuto práci odvede každý, kdo v Česku staví cokoli, co počítá úrok z prodlení nebo valorizaci nájemného, a odvede ji znovu od nuly včetně všech popsaných pastí. U sady ČSÚ jsou navíc podmínky užití v katalogu uvedené tak, že neobsahuje autorská díla ani chráněnou databázi, takže se čísla smějí přepublikovat.
Nechat výsledek venku stojí jedno odpoledne a někomu to ušetří týden.
Berte to jako nabídku. U obou tabulek je vedle lidské podoby i strojově čitelný výstup, takže se dají číst přímo, bez scrapování stránky. Používejte je, jak potřebujete. Jediné, o co prosím, je uvést zdroj, ať se dá dohledat, odkud číslo pochází, a ať případná chyba na naší straně jde vystopovat i u vás.
Když v datech něco nesedí, napište mi. Sazby a indexy jsou svou povahou věc, u které má cenu mít víc párů očí než jeden.
Na těch API není těžké to, co čekáte
Česká veřejná API nejsou špatná, a to je asi nejpřekvapivější závěr celé té práce. ČNB odpovídá rychle, bez klíče a bez registrace. ČSÚ má katalog podle DCAT, živé API v JSON-stat a licenční podmínky, které dovolují data přepublikovat. Mimochodem, jediný zdroj, který nám za celou dobu přestal fungovat, byl ten evropský.
Problém není v jejich kvalitě, ale v tom, že odpovídají přesně na to, na co se ptáte. A ta otázka bývá jiná než ta, kterou máte v hlavě, protože v hlavě máte právní pojem, kdežto v API je struktura odvozená od toho, jak ta instituce data sbírá.
Kdybych měl dát jedinou radu: než integraci pustíte do produkce, ověřte aspoň jednu hodnotu ručně proti nezávislému zdroji, a vyberte si takovou, o které víte, že je hraniční. Většinu popsaných pastí jsme odhalili právě takhle, ještě než se cokoli nasadilo.
Jedinou pastí, která se dostala až do produkce, byl Eurostat. A není náhoda, že to byla zrovna ta jedna, kterou ruční ověření odhalit nemohlo: v den, kdy jsme integraci psali, ta data ještě čerstvá byla.
Na tenhle druh selhání platí jediné: ptát se pravidelně, jestli zdroj ještě žije. Sám vám to totiž neřekne. Řekne vám dvě stě.

- Chcete mít Lupu bez bannerů?
- Chcete dostávat speciální týdenní newsletter o zákulisí českého internetu?
- Chcete mít k dispozici strojové přepisy podcastů?
- Chcete získat slevu 1 000 Kč na jednu z našich konferencí?
Staňte se naším podporovatelem

 ČLÁNKY DO MAILU